
Команда устраняет инцидент техническими средствами, но процесс вокруг сбоя разваливается. По данным «Лаборатории Касперского», при разборе пропущенных инцидентов в информационной безопасности внутренние проблемы с коммуникацией мешали реагированию в 32% случаев.
Дальше события развиваются по сценарию, знакомому любой сервисной функции. Система мониторинга сработала, инженер нашёл причину. Всё рабочее время ушло на выяснение двух вопросов: кто принимает решение и по какому маршруту передавать сообщение.
В этой точке управление инцидентами перестаёт быть чисто технической дисциплиной и переходит в разряд организационных задач. Решающую роль здесь играют четыре фактора:
- роли участников;
- маршруты эскалации;
- нормативы времени;
- порядок информирования бизнеса.
Эти параметры влияют на результат сильнее, чем скорость реакции одного инженера.
22 октября 16:00 МСК Онлайн Бесплатно Онлайн-конференция: Онбординг без созвонов Практика тех, кто каждый день заводит людей в продукт и в партнёрскую сеть. Зарегистрироваться
Цена простоя выросла, а процесс остался прежним
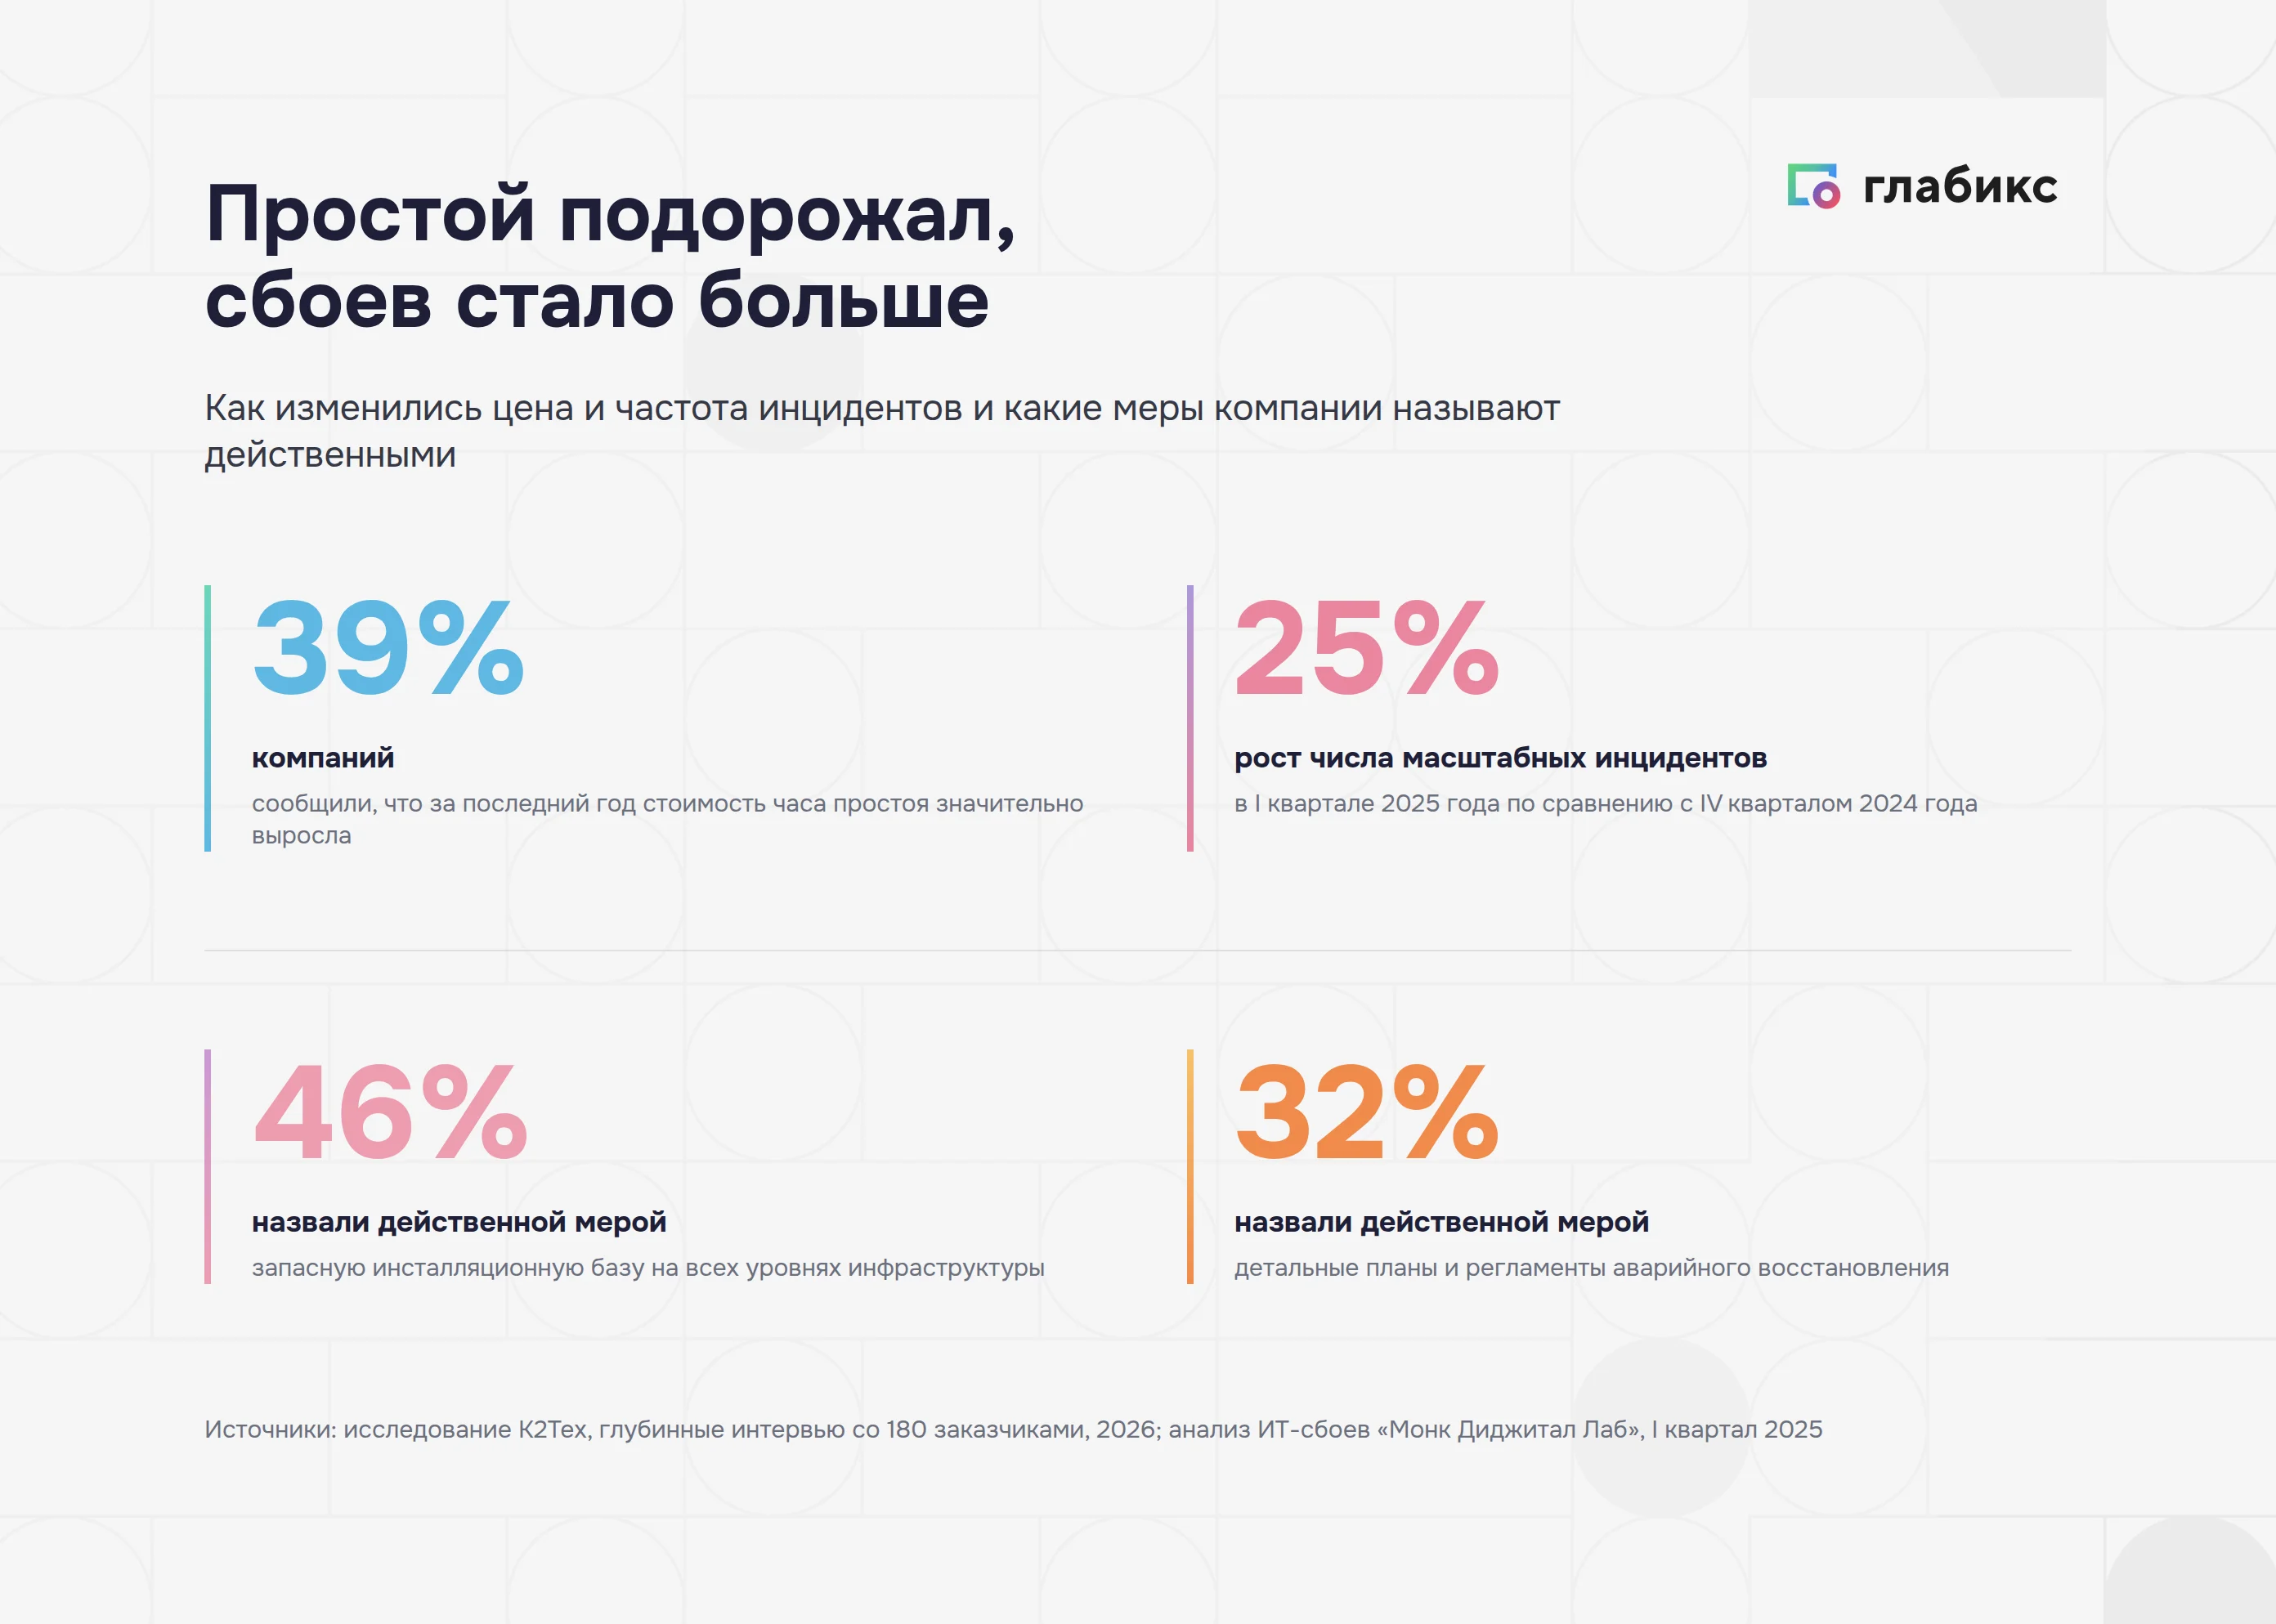
Бизнес оценивает инцидент в деньгах, и за последний год эта цифра изменилась сильнее всего. По данным исследования К2Тех, 39% компаний сообщили, что стоимость часа простоя значительно выросла. Рост объясняют тем, что бизнес сильнее зависит от бесперебойной работы цифровых сервисов. Вместе с ценой вырос и объем работы по возврату услуги: оборудование стареет, инфраструктура неоднородна, вендорская поддержка сокращается.
Частота крупных сбоев сдвинулась в ту же сторону. По данным «Монк Диджитал Лаб», в первом квартале 2025 года количество масштабных инцидентов в российских компаниях выросло на 25% по сравнению с четвертым кварталом 2024 года. Аналитики «Монк Диджитал Лаб» объясняют всплеск участившимися техническими проблемами в инфраструктуре организаций и ростом числа кибератак.
Компании до сих пор называют действенными инженерные меры. Запасную инсталляционную базу на всех уровнях инфраструктуры назвали 46% респондентов, детальные планы и регламенты аварийного восстановления — 32%. Обе меры относятся к подготовке, но вторая распределяет ответственность между сотрудниками: объявление сбоя критичным, переключение нагрузки, сообщение заказчику услуги о прогнозе.
Разговор о регламенте начинается тогда, когда каждый ИТ-сервис получает свою цену простоя для бизнеса.
Без этой цифры приоритеты расставляют по субъективным мнениям:
- для отдела продаж главной остаётся CRM;
- для бухгалтерии — учётная система.
Цену простоя рассчитывает бизнес. Служба управления инцидентами переводит эту сумму в уровень критичности и норматив времени на реакцию. Затем норматив закрепляют в соглашении об уровне услуг — SLA. В разгар технического сбоя этот показатель уже не обсуждают.
Где на самом деле рвется реагирование
Причины технических сбоев в крупных российских компаниях повторяются из квартала в квартал: список у всех команд примерно одинаковый. Источник проблемы лежит в другой плоскости. Разницу в сроках восстановления сервиса создаёт пауза между аварией и первым осмысленным действием инженеров.
Жизненный цикл инцидента описывает библиотека лучших практик ITIL. Российские платформы управления ИТ-услугами, или ITSM-системы, повторяют этот же порядок. Задержку по времени даёт почти каждый шаг маршрута:
- Регистрация. Начинается только после того, как сбой заметят, хотя система мониторинга фиксирует изменение состояния раньше пользователя.
- Классификация. Зависит от понятности категорий.
- Диагностика. Упирается в ответ смежных команд.
- Устранение. Тормозит из-за нехватки ресурсов и прав.
- Закрытие. Задержки почти не дает: услуга уже работает, остается оформить запись.
Передача информации между сотрудниками отдельным этапом в этом списке не выделена, хотя простой копится именно там. Дольше всего инцидент стоит между диагностикой и устранением, когда решение уже найдено, а полномочий на него нет.
Управление инцидентами в ITIL связано с тремя смежными процессами:
- Управление проблемами. Ищет первопричину повторяющихся сбоев, пока услугу держат на обходном пути.
- Управление изменениями. Ведет релизы и окна обновлений, держит порядок отката и связь сбоя с последней выкаткой.
- Управление конфигурациями. Хранит перечень серверов, приложений и ИТ-сервисов вместе со связями между ними, поэтому показывает, что именно откажет вместе с конкретным узлом.
Процессы связаны между собой. Если инцидент закрыли, а первопричину не искали, следующая авария придет от того же оборудования.
Причины инцидентов и этапы, которые остаются без владельца
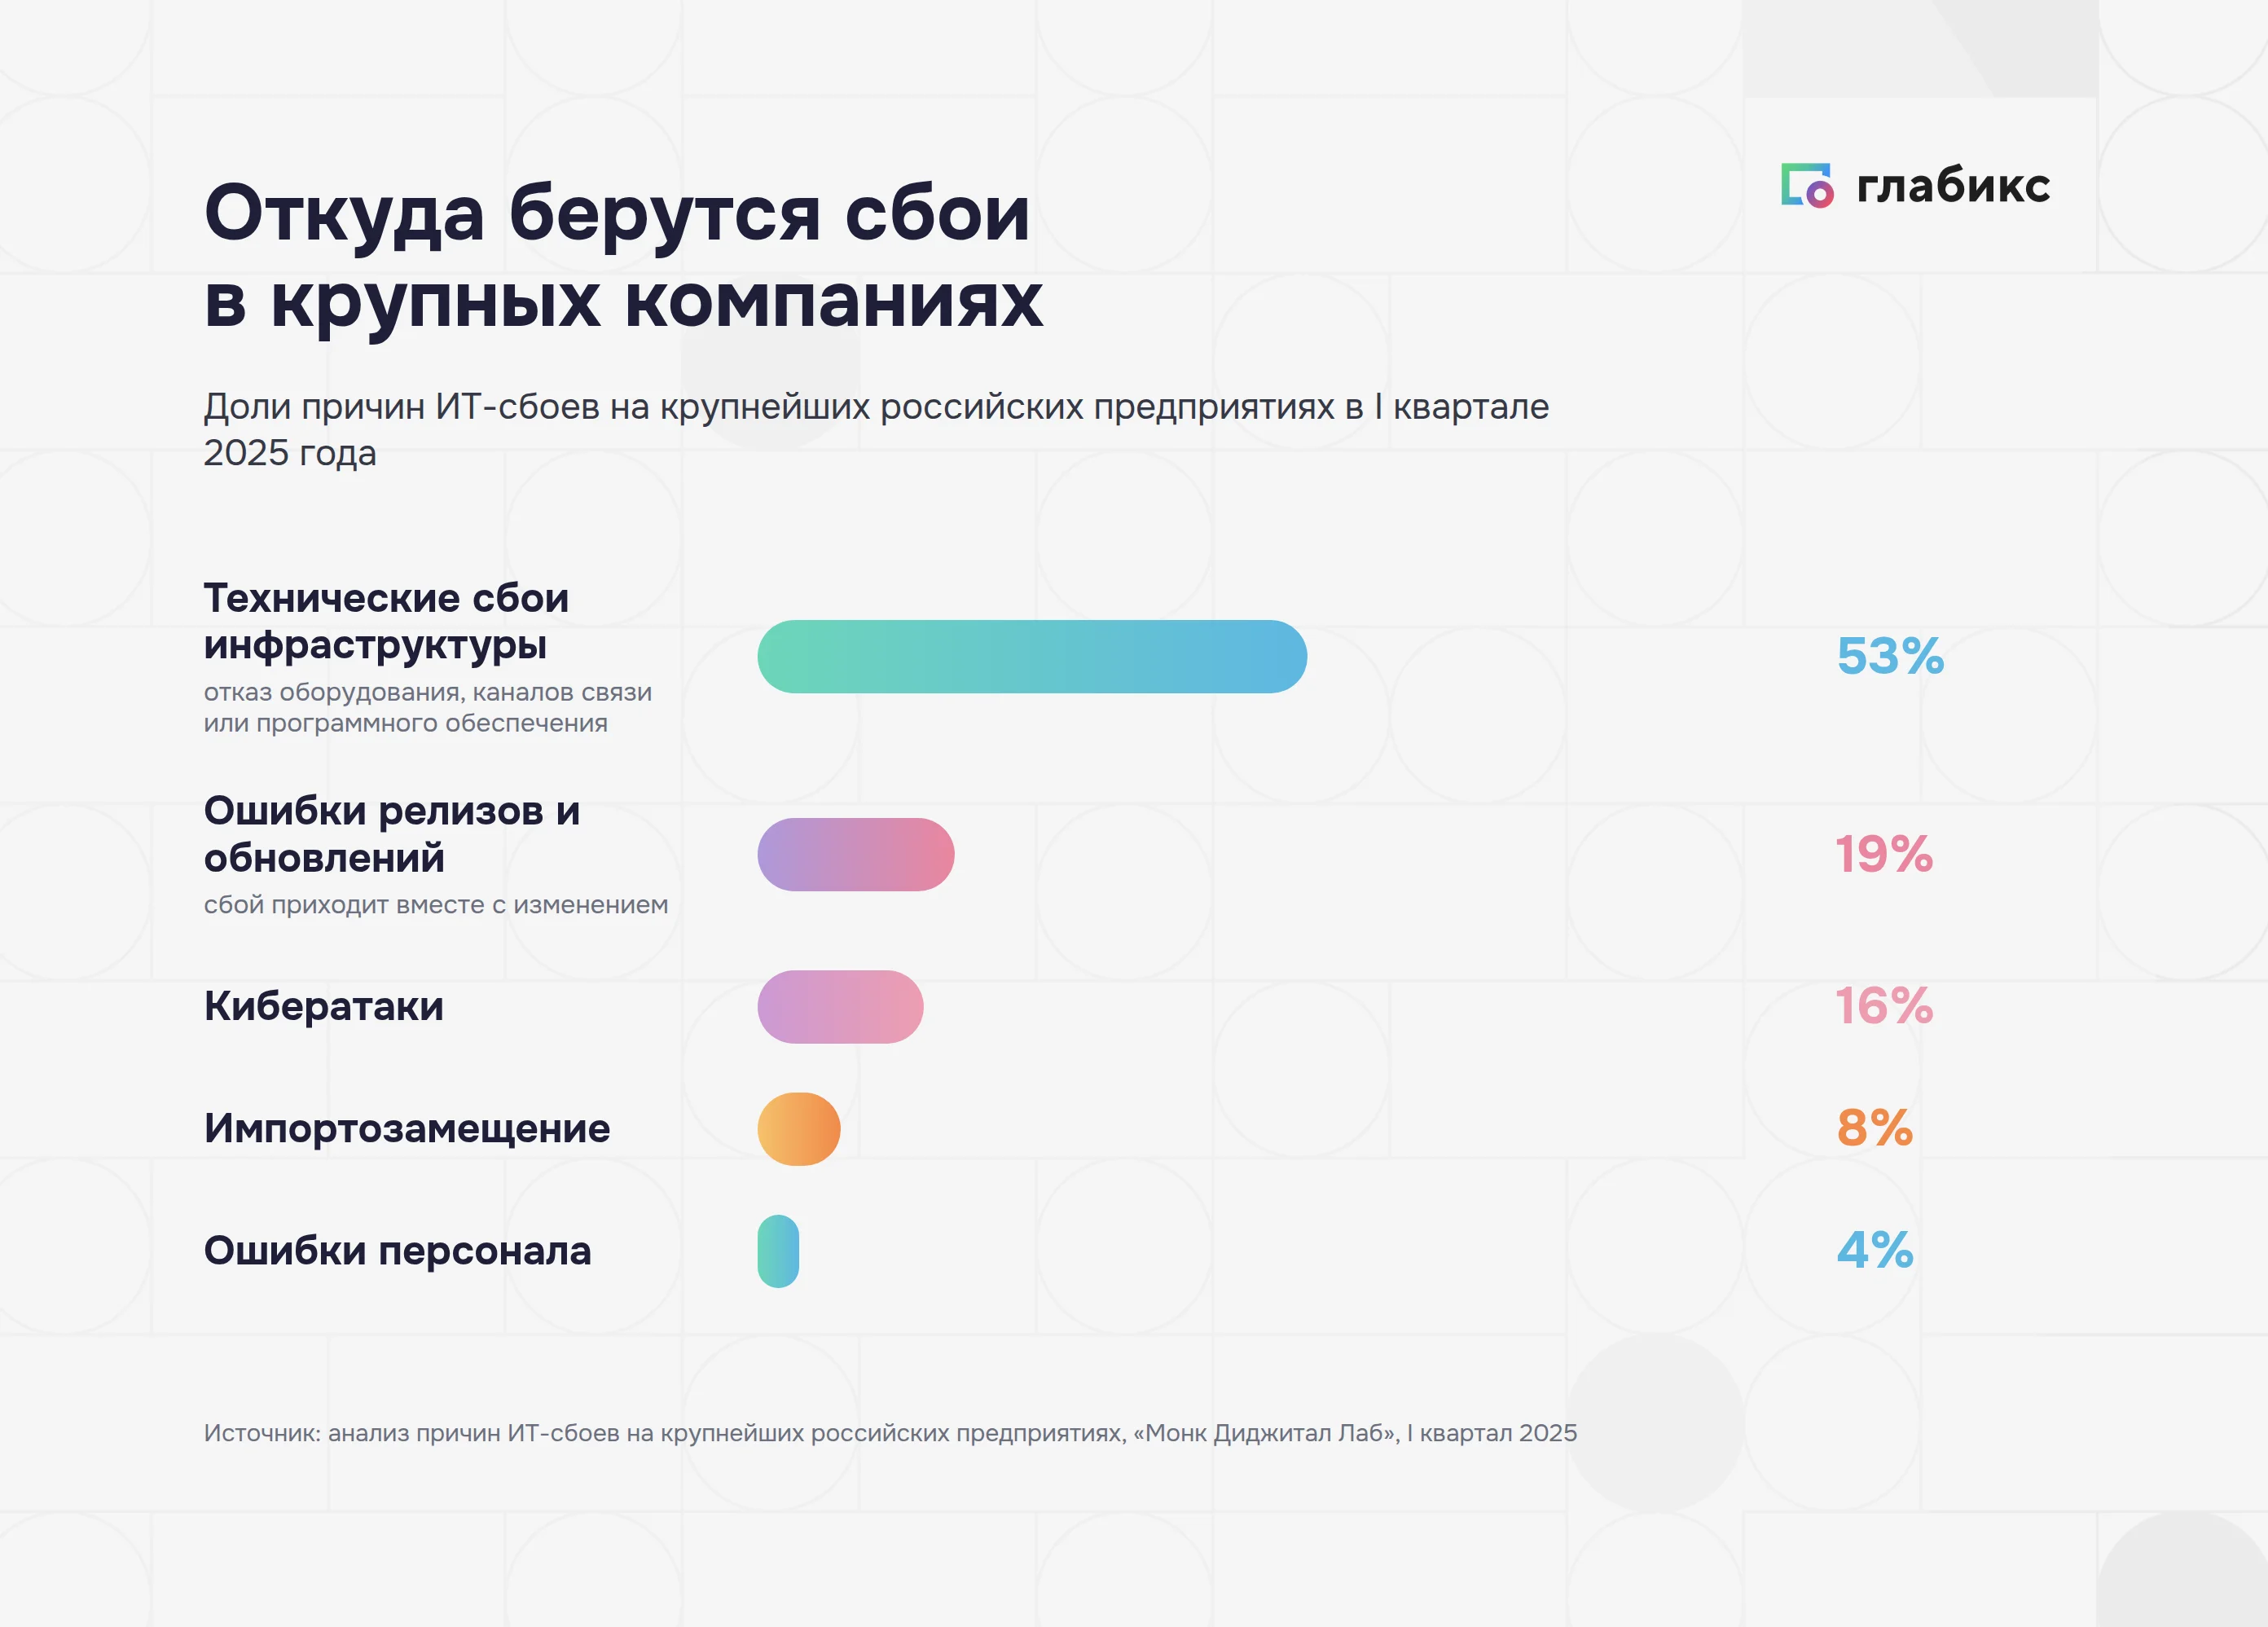
Отчет «Монк Диджитал Лаб» о том же всплеске инцидентов раскладывает причины так:
- Технические сбои инфраструктуры — 53%. Отказ оборудования, каналов связи или программного обеспечения из-за износа или перегрузок.
- Ошибки релизов и обновлений — 19%. Сбой приходит вместе с изменением, которое команда внесла своими руками.
- Кибератаки — 16%.
- Импортозамещение — 8%.
- Ошибки персонала — 4%.
Причины из списка объясняют, откуда берется сбой, но скорость реагирования не определяют: отказ диска и неудачное обновление одинаково быстро видны в системе мониторинга. Дальше начинается участок, за который отвечают сотрудники.
Путаница возникает на этапе приёма заявок.
Инцидент прерывает нормальную работу сервиса для пользователей. Запрос на обслуживание фиксирует стандартную потребность:
- выдать доступ;
- завести новую учётную запись;
- установить приложение.
В общей очереди оба потока попадают к одним специалистам. Запросы вытесняют аварии, потому что типовую задачу закрыть быстрее. Раздельные очереди устраняют конфликт приоритетов без расширения штата поддержки.
Ошибки релизов связывают управление инцидентами с управлением изменениями. Выявление сбоя после релиза запаздывает там, где нет мониторинга пользовательского опыта и налаженной схемы дежурств. Так закрывается разрыв между сигналом и человеком, который на него отвечает.
Часть инцидентов не попадает в цикл вовсе. В разборе «Лаборатории Касперского» инциденты высокой степени критичности в 52% случаев обнаруживали только через 90 дней. Пропускают их там, где ждут сигнала от пользователя и не разбирают журналы регулярно.
За три месяца в компании меняется состав команды, закрываются проекты, истекает срок хранения журналов. К моменту обнаружения инцидент обрастает последствиями, которые уже никто не связывает с исходной причиной.
«Компании сталкиваются не только с внешними рисками, но и со скрытыми угрозами внутри своей инфраструктуры, причем признаки компрометации не всегда очевидны».
Виктор Сергеев, руководитель команды реагирования на инциденты «Лаборатории Касперского»
Кто кому сообщает во время инцидента
Техническую часть реагирования регламентируют почти всегда: дежурный ИТ-инженер знает, какие метрики отслеживать и какую команду подключать к сбою. При этом порядок оповещения между разными ролями часто выпадает из процесса.
В разборе «Лаборатории Касперского» выделяют две типовые проблемы:
- договорённости фиксируют двусмысленно;
- знания уходят из компании вместе с сотрудниками.
Обе сложности возникают на стыке ролей. Инженер уверен, что согласовал решение, а руководитель слышит в этом же разговоре сомнения. Уволившийся специалист уносит с собой весь опыт, который команда не зафиксировала в регламентах.
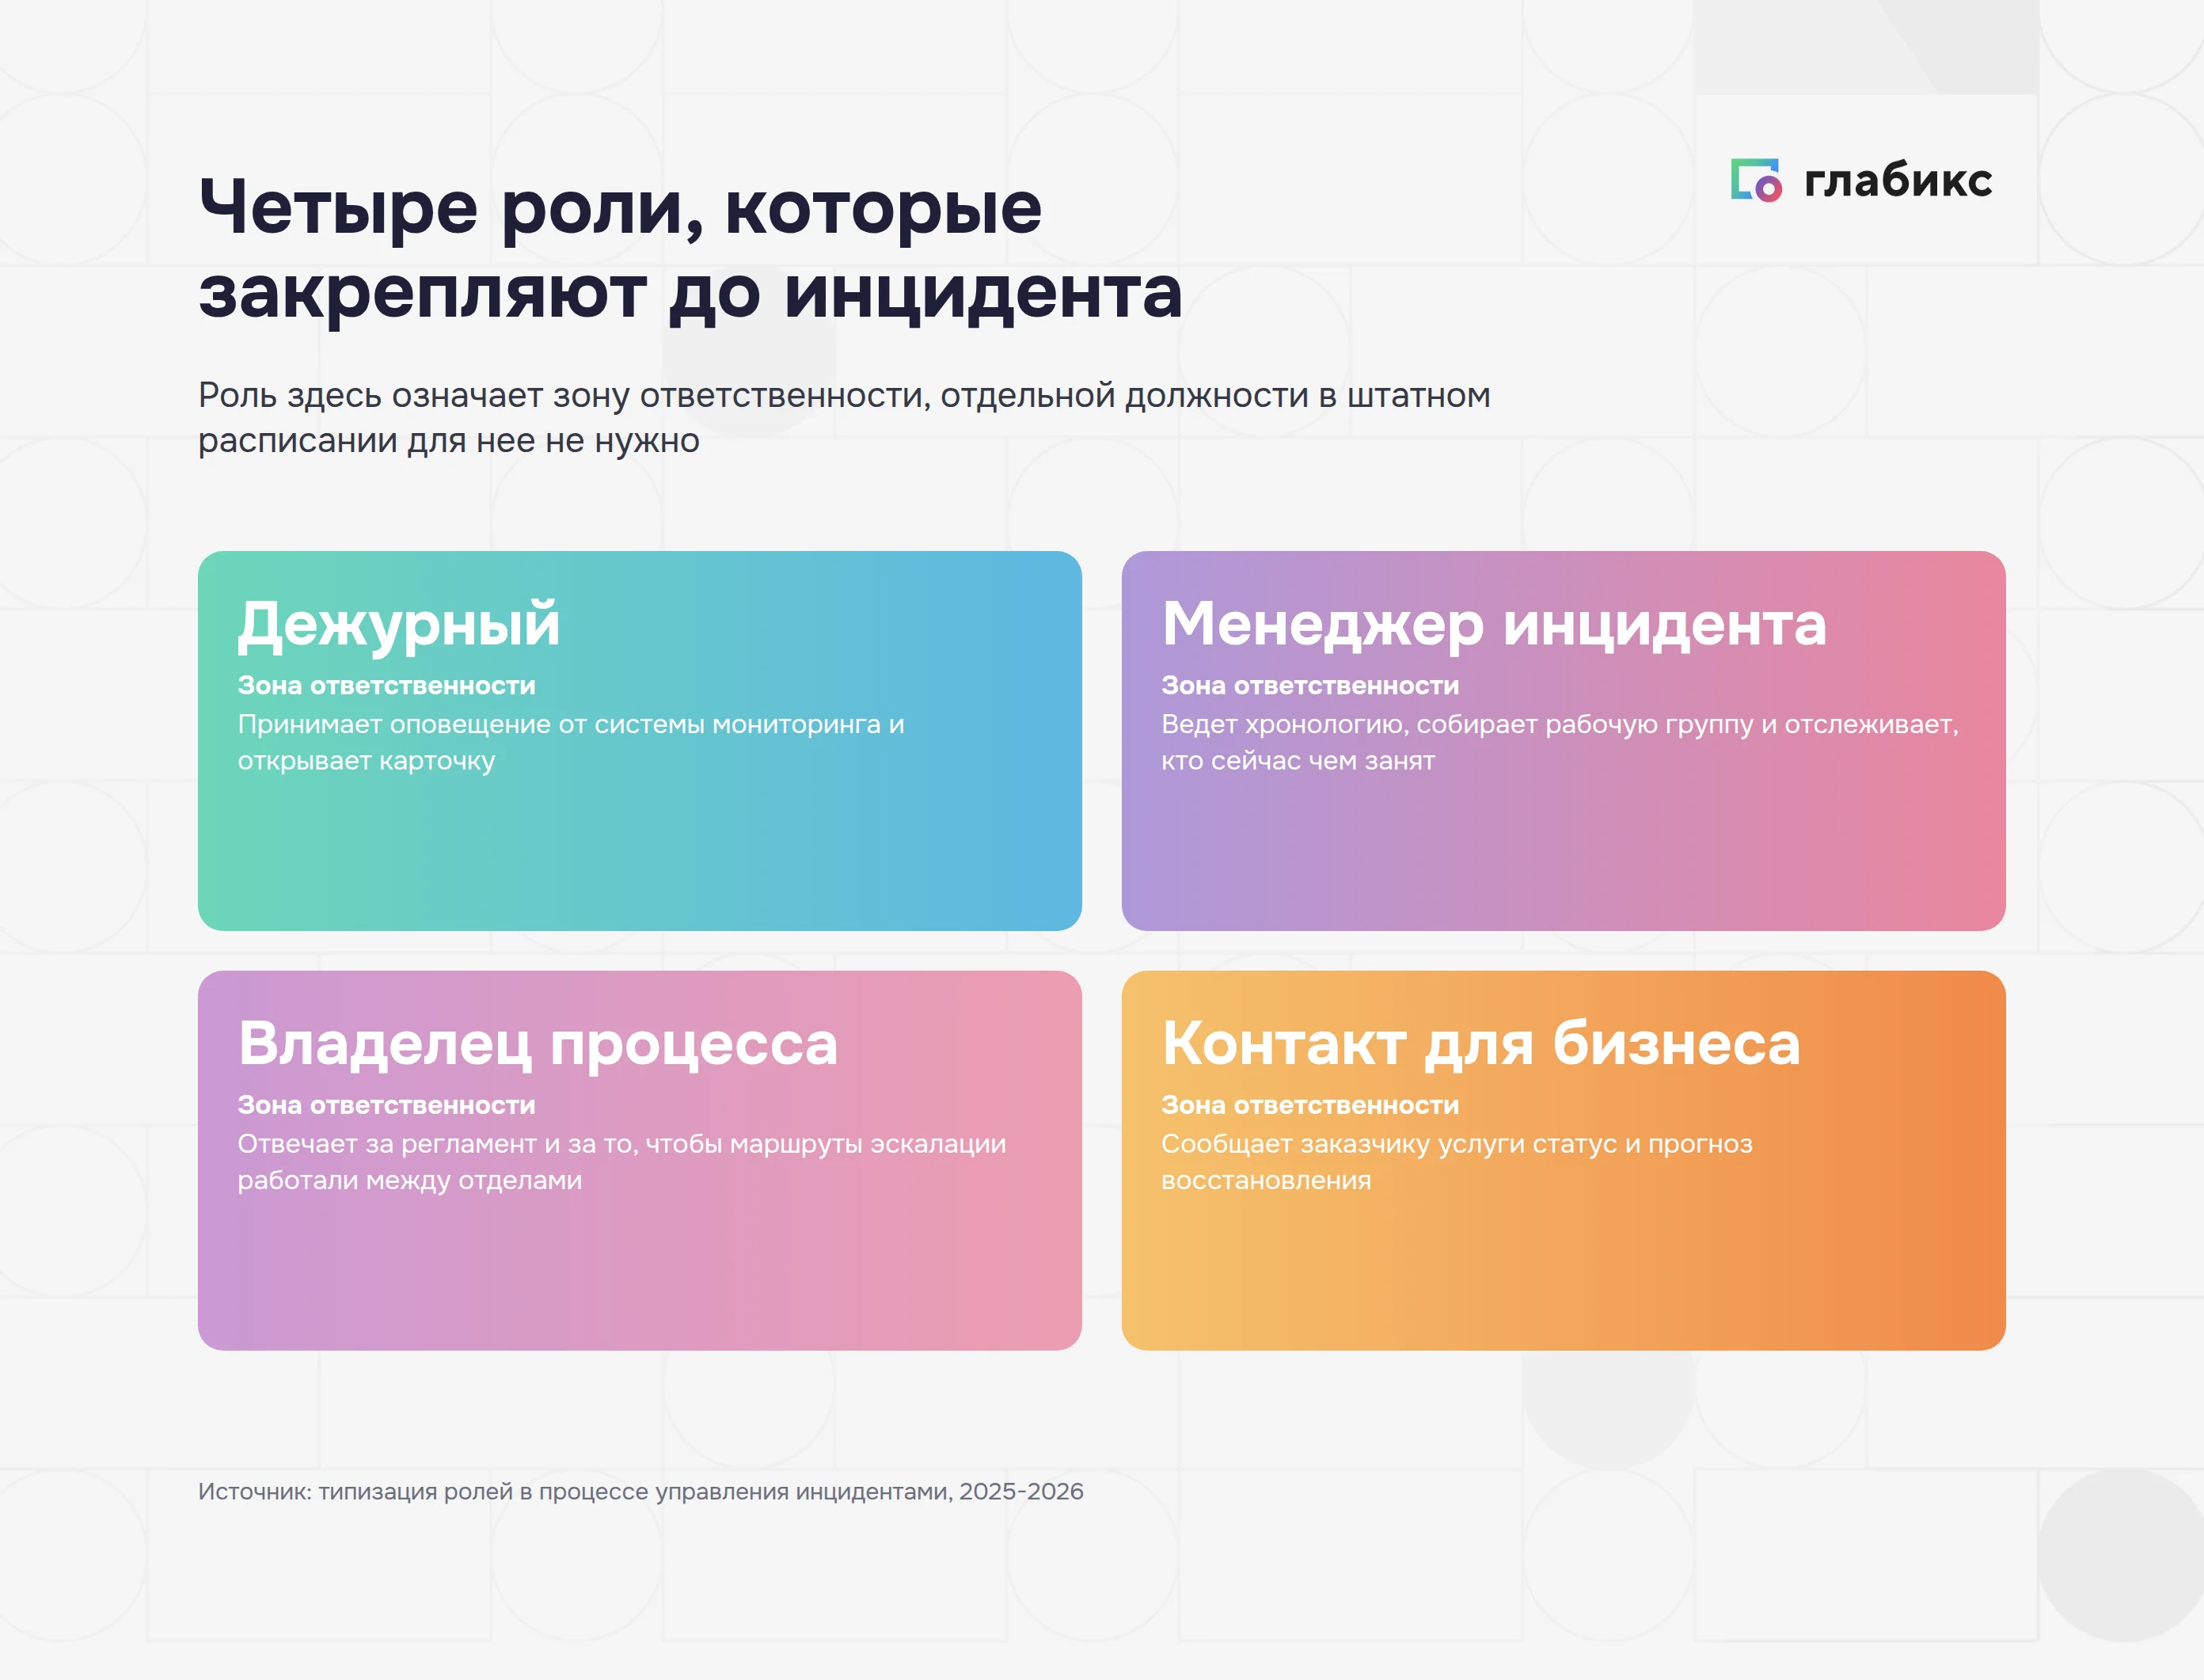
Минимальный набор ключевых ролей стоит закрепить до инцидента:
- Дежурный. Принимает оповещение от системы мониторинга и открывает карточку.
- Менеджер инцидента. Ведет хронологию, собирает рабочую группу и отслеживает, кто сейчас чем занят.
- Владелец процесса. Отвечает за регламент и за то, чтобы маршруты эскалации работали между отделами.
- Контакт для бизнеса. Сообщает заказчику услуги статус и прогноз восстановления.
Роль здесь означает зону ответственности, отдельной должности в штатном расписании для нее не нужно. На практике один инженер небольшого ИТ-отдела совмещает сразу две роли.
Внутренние обязательства подразделений друг перед другом фиксирует соглашение об операционном уровне услуг — OLA.
Внешнему клиенту компания даёт SLA. Этот норматив напрямую опирается на OLA: первая линия поддержки не назовёт срок клиенту, если смежная техническая команда не подтвердила свои обязательства.
Порядок информирования регламентируют так же подробно, как техническую часть. Регламент определяет три параметра:
- список получателей оповещения;
- единый канал для обновлений;
- точный интервал публикации статусов.
Рабочий минимум включает командный чат в мессенджере и письмо по электронной почте для заказчика сервиса. Без фиксированного интервала руководители запрашивают новости поодиночке. В результате дежурный инженер бросает устранение сбоя и тратит время на ответы.
Одно общее обновление для всех останавливает поток личных сообщений и сохраняет цифровой след для будущего разбора инцидента.
Первым о сбое сообщает система мониторинга
Между началом технического сбоя и регистрацией инцидента проходит «серая зона» времени, которую мало кто замеряет. Если заявку создаёт пользователь, скорость реакции службы поддержки упирается в два фактора:
- терпение сотрудника;
- знание регламента и маршрута обращения.
Время реакции и время восстановления сервиса сокращают разными инструментами. Первый показатель напрямую зависит от точки входа инцидента в очередь задач. Ускорить процесс помогает интеграция системы мониторинга с сервис-деском — платформой приёма и маршрутизации обращений. Инцидент создаётся автоматически при превышении порогового значения и сразу уходит профильной команде.
Автоматическая регистрация имеет скрытый риск. Мониторинг реагирует даже на безопасные колебания параметров. Пороги срабатывания настраивают строго вместе с владельцем ИТ-услуги, иначе поддержка захлебнётся в потоке ложных оповещений и потеряет доверие к сигналам системы. Техническое событие становится инцидентом только тогда, когда оно нарушает реальную работу пользователей, а не просто меняет цифру на графике мониторинга.
Так устроена регистрация в ICL Services: компания перевела внутреннюю службу поддержки на платформу ELMA365. Уровень услуги там рассчитывают под условия каждого договора. Заявки создаются автоматически: их заводят несколько серверов Zabbix.
Панели аналитики отслеживают три ключевых показателя:
- время реакции;
- нагрузку на команду;
- долю повторных инцидентов.
По внутренней статистике компании, внедрение инструментов сократило время реакции на инциденты на 40%. Объём ручного труда снизился на 25%.
Автоматическое создание инцидента переносит задачу на уровень выше. Теперь ключевое значение имеют два параметра: роль получателя сигнала и маршрут дальнейшей передачи данных. Такой разрыв между сигналом и ответственным за решение возникает не только в технической поддержке, но и за пределами ИТ-инфраструктуры.
Инцидент за пределами ИТ: ремонт оборудования в сети пиццерий
Сервисная функция появляется там, где простой оборудования оборачивается потерей выручки. В общепите и рознице инцидент принимает форму сломанной печи вместо упавшего сервера. При этом процесс вокруг сбоя выстроен одинаково.
В распределённой сети цепочка реагирования рвётся в одной точке: у поломки нет единого владельца. Сотрудник пиццерии звонит знакомому мастеру. Управляющий пишет в общий чат. Подрядчик узнаёт об аварии последним. Каждая точка выстраивает собственный порядок, поэтому единого норматива решения в сети не существует.
Кроме владельца заявки, маршрут опирается на строгий учёт оборудования. В ITIL каждую такую позицию называют конфигурационной единицей, а на кухне ей присваивают инвентарный номер. Заявку привязывают к этому номеру. Накопленная история ремонтов показывает, когда очередная починка перестаёт окупаться.
Истории ремонтов со всей сети сводят в единую базу данных конфигураций — CMDB. Без неё команда видит только бессистемный поток заявок и не замечает, что одна и та же печь ломается четвёртый раз за квартал.
Сервисный подрядчик работает по тем же правилам, что и штатная команда. В договор вносят формулировки базового регламента:
- срок приезда мастера;
- порядок замены деталей;
- действия при срыве норматива.
Без этих условий заказчик и сервисная компания понимают норму по-разному.
Например, ИТ-команда Dodo Brands — Dodo Engineering — автоматизировала ремонт и замену кухонного оборудования в пиццериях «Додо Пицца». Сотрудник оставляет заявку через портал самообслуживания. Дальше система ведёт сквозной маршрут:
- согласование ремонта;
- выдача подменного оборудования;
- списание материалов со склада.
Процесс собран на облачной платформе Naumen Service Desk, федеральные подрядчики подключены к ней через программный интерфейс. По собственным данным компании, заявки обрабатываются в среднем в 2,5 раза быстрее, а система охватывает более 150 пиццерий сети.
Единый маршрут закрепляет общий норматив для всех точек и заменяет то, что в одном офисе решается разговором в коридоре. На следующем масштабе задача меняется еще раз: исход начинает зависеть от очередности.
Приоритет и эскалация, когда обращений десятки тысяч в месяц
Пока в службу поддержки поступают десятки заявок в день, операторы назначают приоритет вручную и помнят ключевых клиентов наизусть. Ручная сортировка перестаёт работать на потоке в десятки тысяч обращений в месяц. Такой масштаб принципиально меняет подход к обработке заявок.
Оценка критичности по интуиции оператора приводит к закономерному перекосу:
- эмоциональный клиент сразу получает высокий приоритет;
- сдержанный пользователь остаётся с низким приоритетом.
Субъективность устраняет матрица влияния на бизнес. Норматив времени реакции определяют два параметра: категория заявки и гарантированный уровень сервиса. Эмоциональный тон письма на приоритет больше не влияет.
Приоритет складывается из двух оценок:
- Влияние. Сколько пользователей и какие бизнес-процессы затронуты.
- Срочность. Как быстро последствия станут необратимыми.
Пересечение этих оценок дает уровень критичности, а он уже привязан к нормативу из SLA.
Пока обе оценки заданы словами вроде «критично» и «важно», матрица остается формальностью: каждый специалист понимает их по-своему. В рабочей шкале стоят числа: сколько пользователей затронуто и за сколько часов последствия станут необратимыми.
Эскалация в ITIL бывает двух видов, и путать их дорого:
- Функциональная. Передает инцидент специалисту с нужной квалификацией: первая линия отдает его второй, та — команде разработки. Задается маршрутом в системе.
- Иерархическая. Поднимает инцидент по управленческой вертикали, когда норматив под угрозой и нужно решение о ресурсах. Держится списком имен и телефонов.
И схема маршрутизации, и список контактов устаревают быстрее, чем их пересматривают.
Инструменты автоматизации исключают ручное распределение задач. Платформа ITSM выполняет три стандартных действия:
- присваивает категорию по типовому шаблону;
- назначает ответственного исполнителя;
- повышает уровень эскалации при срыве норматива.
Объём рутинной сортировки сокращается. Споры о приоритетах перемещаются из переписки в область настройки системных правил.
Программный инструмент закрепляет принятые решения, но не заменяет собой проектирование процессов. Матрицу влияния, маршруты передачи заявок и нормативы времени определяют до старта проекта. Иначе система автоматизирует прежний хаос, только на более высокой скорости. Выбор конкретной платформы сервис-деска влияет на итоговый результат слабее, чем предварительное описание маршрутов.
Сервисный центр технической поддержки Positive Technologies работает с клиентами по преднастроенным процессам управления инцидентами, проблемами и изменениями. Многоуровневые SLA заданы под разные продуктовые команды и категории заказчиков. Режимы обслуживания разделены на круглосуточный и рабочий день. Эскалация из коммерческого блока в команды разработки идет автоматически: обязательства между подразделениями заданы в OLA, а процессы собраны на платформе SimpleOne ITSM. Компания сообщает, что систему открывают около 10 000 сотрудников, а поток составляет порядка 40 000 новых обращений в месяц.
От реакции к предупреждению: что меняется после разбора
От обычного отчёта постмортем отличает одна деталь: у каждого вывода есть ответственный и понятный срок сдачи. Без этих параметров разбор превращается в документ для архива. Частота инцидентов при этом не меняется.
Постмортем, или разбор без поиска виноватых, держится на одном условии: участники восстанавливают честную хронологию событий и не тратят силы на оправдания. Инженер под угрозой наказания описывает удобную версию вместо реальной картины. В результате ключевая точка потери времени в хронологии просто не появляется.
Разбор имеет смысл, когда на выходе появляются четыре строки:
- Фиксация хронологии. Когда сбой начался, когда его заметили, когда подключили нужного специалиста.
- Точка потери времени. Участок, где инцидент стоял без движения, с указанием причины остановки.
- Исправление в процессе. Правка регламента, маршрута эскалации или порога срабатывания.
- Ответственный и дата. Имя сотрудника за правкой и день, когда она появится в регламенте.
Единый шаблон экономит ресурсы команды на следующем постмортеме: инженеры ведут анализ по готовым полям и не зависят от личной памяти участников. Фиксация хронологии сразу после восстановления сервиса обходится дешевле и даёт более точные данные, чем запоздалая реконструкция событий по рабочей переписке.
Качество проведённого разбора проверяют через квартал: повторяющийся тип инцидента либо полностью исчезает из журнала, либо остаётся в нём. Без регулярной сверки любая корректировка процесса превращается в формальную строку регламента, которую никто не читает.
Систематический сбой переводят из контура управления инцидентами в управление проблемами. Поиск фундаментальной первопричины занимает недели. Готовая инструкция, зафиксированная в базе знаний один раз, снижает нагрузку на первую линию поддержки и сокращает время закрытия аналогичных заявок.
Профилактику аварий связывают с управлением изменениями. Релиз, вызвавший падение сервиса, анализируют по трём критериям:
- наличие согласованного окна изменений;
- готовность плана отката;
- состав дежурной смены в момент выкатки.
Разбор инцидента и аудит релиза формируют единый перечень правок в регламенте.
При реактивной модели команда возвращает сервис в строй и закрывает задачу. Проактивный подход фокусируется на снижении вероятности повторных сбоев. Комплекс превентивных мер обходится бизнесу дешевле одного масштабного простоя:
- регулярные учения;
- аудит порогов мониторинга;
- системный разбор изменений.
Одних записей в регламенте мало. В «Лаборатории Касперского» рекомендуют отрабатывать взаимодействие между участниками процесса так же регулярно, как техническую часть сценариев реагирования, и проверять на тех же учениях соблюдение OLA.
Новичков учат на разобранных инцидентах: вместо абстрактных сценариев они получают хронологию реального сбоя. Так знание о процессе остается в команде, даже когда уходит автор регламента.
«По мере усложнения ИТ-ландшафта и роста стоимости простоев сервисная поддержка перестает быть только функцией реагирования на сбои. Согласно исследованию, заказчики все выше ценят не только скорость и экспертизу, но и проактивность, запрос на нее вырос на 25% год к году».
Наталия Сляднева, руководитель Центра экспертизы по комплексному сервису «К2Тех»
Метрики, которые стоит ставить сервисной функции
Набор метрик под управление инцидентами обычно берут из ITIL целиком. Работает из этого набора небольшая часть: показатели, которые описывают узкое место конкретного процесса.
Измерять начинают со времени. Серьезные сбои в первом квартале 2025 года длились от 30 минут до 4 часов, в ряде случаев до 72 часов. Такой диапазон плохо сворачивается в одно число. Цель по времени восстановления ставят для критических услуг, для остальных норматив задают мягче.
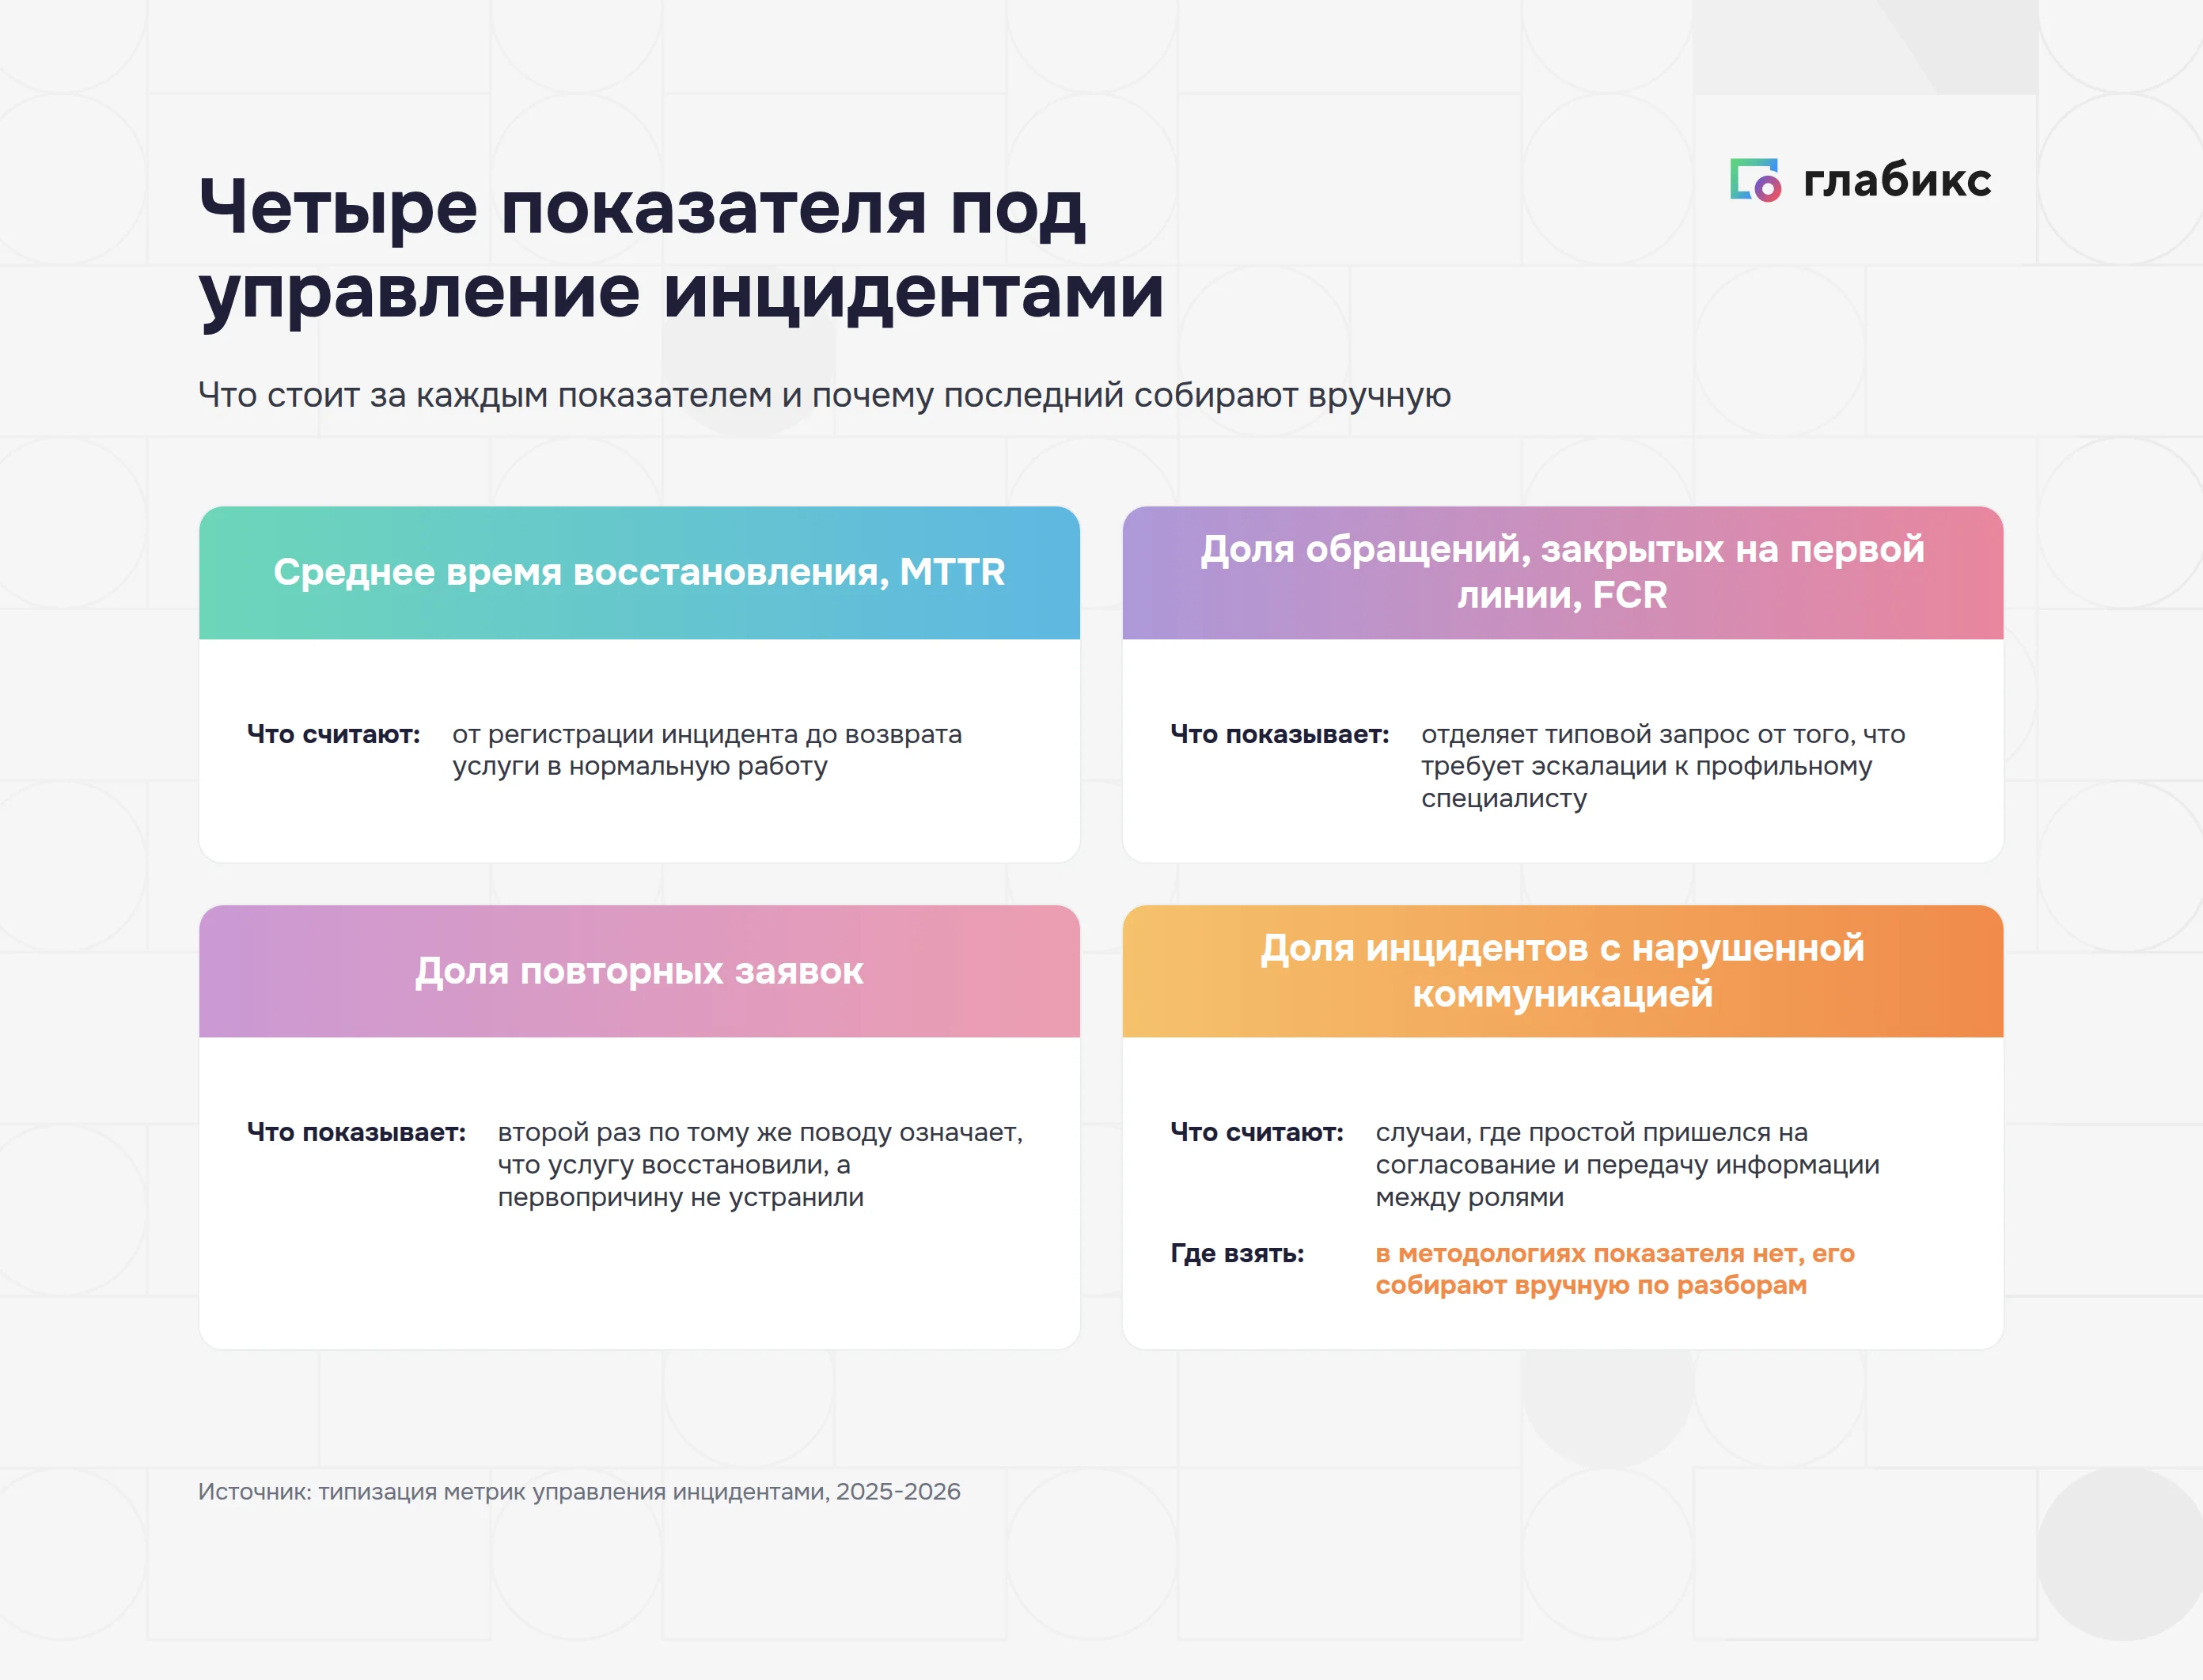
Под управление инцидентами обычно ставят четыре показателя:
- Среднее время восстановления, MTTR. Считают от регистрации инцидента до возврата услуги в нормальную работу.
- Доля обращений, закрытых на первой линии, FCR. Отделяет типовой запрос от того, что требует эскалации к профильному специалисту.
- Доля повторных заявок. Второй раз по тому же поводу означает, что услугу восстановили, а первопричину не устранили.
- Доля инцидентов с нарушенной коммуникацией. Считают случаи, где простой пришелся на согласование и передачу информации между ролями.
Последнего показателя в методологиях нет — собрать его можно только разбором хронологий. Зато он единственный измеряет ключевой участок, где уходят часы.
Собирают его вручную. В каждом разборе отмечают, сколько инцидент ждал согласования, сколько времени ушло на ответ смежной команды и когда владелец услуги подтвердил решение. Из суммы таких интервалов за квартал складывается цена неописанной коммуникации. Финансовый директор поймет такой счет быстрее, чем долю закрытых заявок. В отчет для бизнеса идут число инцидентов, число задетых пользователей, длительность простоя и ущерб в деньгах.
Ручной контроль держится недолго. Дальше показатели переносят в ITSM-систему: отчёты формируются автоматически из полей разбора. Квартальная сводка наглядно показывает участки, где процесс проседает систематически. Зрелость управления инцидентами определяют динамика этих цифр и качество собранных данных.
Ориентиры по каждому показателю компания задаёт самостоятельно. Отсчёт ведут от двух параметров: собственных замеров за прошлый квартал и цены ошибки в своей отрасли. Норматив обслуживания для розничной сети, где единичный сбой при обработке заказа ведёт к прямым убыткам, принципиально отличается от норматива для внутреннего корпоративного портала.
При этом ни одна метрика не измеряет главного: понимал ли каждый участник свою задачу на старте инцидента. Такую договорённость закрепляют в регламенте:
- список ролей;
- маршруты эскалации;
- контроль сроков;
- обязательство информировать бизнес о статусе работ.
Управление инцидентами начинает предупреждать аварии только тогда, когда эти правила прописаны так же подробно, как инженерная инструкция.
Другие статьи по теме
Часто задаваемые вопросы
Почему инциденты устраняют медленно, даже если причина найдена быстро?
По данным «Лаборатории Касперского», при разборе пропущенных инцидентов внутренние проблемы с коммуникацией мешали реагированию в 32% случаев. Дольше всего инцидент стоит между диагностикой и устранением, когда решение уже найдено, а полномочий на него нет. Результат определяют роли участников, маршруты эскалации, нормативы времени и порядок информирования бизнеса.
Какие роли закрепить в процессе управления инцидентами?
Минимальный набор — четыре роли: дежурный принимает оповещение и открывает карточку, менеджер инцидента ведет хронологию и собирает рабочую группу, владелец процесса отвечает за регламент и маршруты эскалации, контакт для бизнеса сообщает заказчику статус и прогноз. Роль означает зону ответственности, а не отдельную должность: в небольшом ИТ-отделе один инженер совмещает две роли.
Чем SLA отличается от OLA?
SLA — соглашение об уровне услуг, которое компания дает внешнему клиенту. OLA фиксирует внутренние обязательства подразделений друг перед другом. SLA напрямую опирается на OLA: первая линия не назовет срок клиенту, если смежная техническая команда не подтвердила свои обязательства.
Как определить приоритет инцидента?
Приоритет складывается из двух оценок: влияния (сколько пользователей и какие бизнес-процессы затронуты) и срочности (как быстро последствия станут необратимыми). Пересечение оценок дает уровень критичности, привязанный к нормативу из SLA. В рабочей шкале стоят числа, а не слова вроде «критично», иначе каждый специалист понимает их по-своему.
Чем функциональная эскалация отличается от иерархической?
Функциональная эскалация передает инцидент специалисту с нужной квалификацией: первая линия отдает его второй, та — команде разработки, и задается она маршрутом в системе. Иерархическая поднимает инцидент по управленческой вертикали, когда норматив под угрозой и нужно решение о ресурсах. Она держится списком имен и телефонов.
Что должно получиться на выходе постмортема?
Разбор имеет смысл, когда в нем есть хронология сбоя, точка потери времени с причиной остановки, исправление в регламенте, маршруте эскалации или пороге срабатывания, а также ответственный и дата. Постмортем проводят без поиска виноватых, иначе инженер описывает удобную версию вместо реальной картины. Качество разбора проверяют через квартал: повторяющийся тип инцидента либо исчезает из журнала, либо остается.
Какие метрики ставить под управление инцидентами?
Обычно ставят четыре показателя: среднее время восстановления MTTR, долю обращений, закрытых на первой линии (FCR), долю повторных заявок и долю инцидентов с нарушенной коммуникацией. Последнего показателя в методологиях нет, его собирают вручную разбором хронологий. Зато он единственный измеряет участок, где уходят часы.